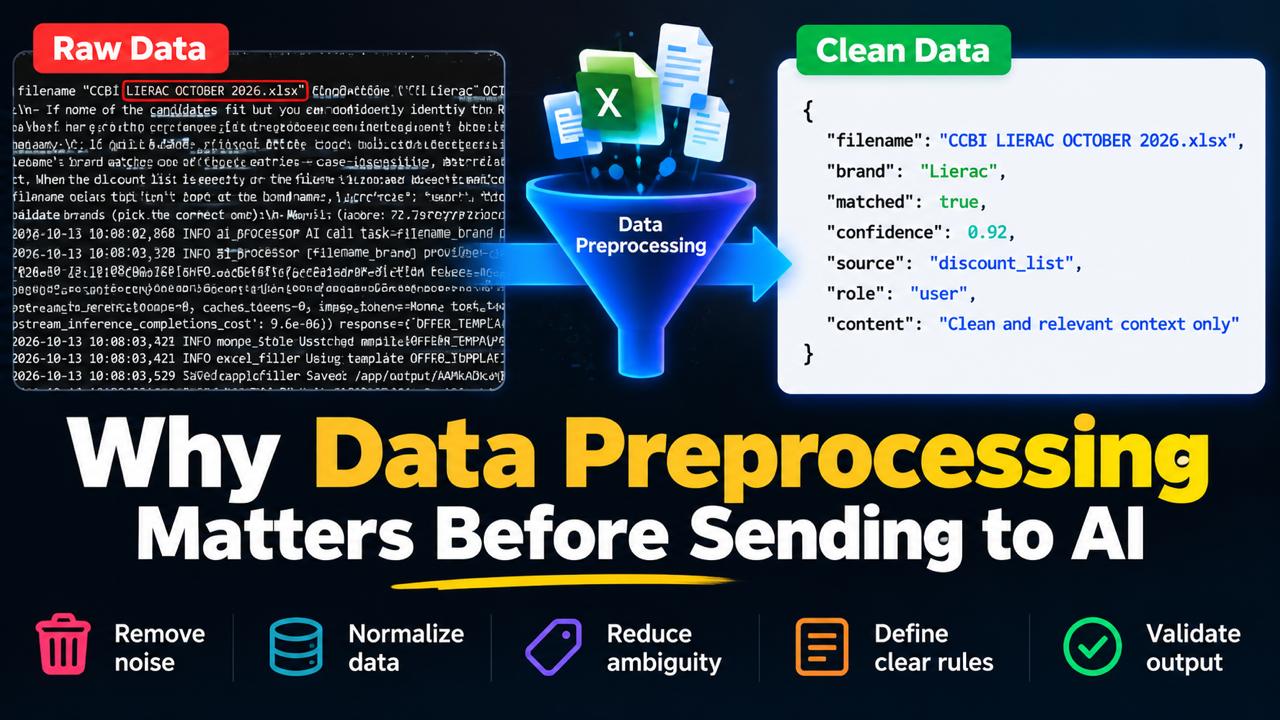
Trong một pipeline phân loại đã chạy thật — 24.216 item thô, 11.922 ứng viên gửi cho model, 18.529 dòng kết quả, 6.672 dòng dùng được — phần lớn lỗi không đến từ model mà đến từ dữ liệu vào và từ việc không kiểm tra dữ liệu ra. Dưới đây là năm bước, mỗi bước kèm con số đã đo.
1. Cắt bằng code trước khi tốn token
- Bộ lọc từ khoá bỏ 50,8% item thô (24.216 → 11.922 ứng viên) mà không gọi model lần nào. Nó lọc theo hình thức chứ không theo nghĩa, nên vẫn để lọt nhiều — và điều đó là đúng, xem mục 4.
- Payload cắt mỗi item ở 1.100 ký tự, nhưng bản lưu không giữ độ dài gốc, nên không kiểm chứng được việc cắt đã ảnh hưởng thế nào. Cắt thì phải ghi lại đã cắt gì.
2. Chuẩn hoá trước khi so khớp
- Khoá resume ban đầu là 150 ký tự đầu của văn bản: trùng ở 1.903 dòng. Khoá phải là id của item, không phải chữ.
- 518 nhóm cùng (nguồn, 160 ký tự đầu) nhưng trích dẫn khác nhau — cùng một item được phân loại nhiều lần, có nhóm tới 7 lần, và không nhãn nào chiếm đa số để tự động chọn. Chuẩn hoá và khử trùng là việc của code, không phải của model.
3. Giữ danh mục trong code, đừng để model tự nghĩ nhãn
Taxonomy cố định, do code giữ, và mọi nhãn ngoài danh mục đều bị từ chối: 60% dòng có nhãn nằm ngoài taxonomy hoặc để rỗng. Chỉ lọc theo điều kiện “có nhãn” là đủ để bảng xếp hạng sai ngay từ đầu.
4. Cho model quyền trả null, và chấp nhận null
- 59,7% item không mang nhãn vấn đề nào, và phần lớn số đó là null thật: câu hỏi how-to, khoe thành tích, quảng cáo, review 5 sao.
- Null không phải lỗi cần sửa. Ép model luôn gán một nhãn sẽ tạo ra nhãn sai, mà nhãn sai tốn kém hơn null rất nhiều.
5. Kiểm tra dữ liệu ra trước khi dùng
- 29 lần trường “cách làm tạm” trả về object thay vì chuỗi. JSON vẫn parse được, code vẫn chạy, dữ liệu vẫn mất. Kiểm tra kiểu của từng trường, không chỉ kiểm tra parse.
- 18.529 dòng kết quả nhưng chỉ 6.672 dòng dùng được: phần còn lại không biến mất, nó nằm ở nhóm null hợp lệ và nhóm nhãn lệch danh mục.
- Số token thật chưa được log ở phía gateway, nên mọi con số chi phí chỉ là ước lượng — và như vậy thì không biết bước nào tốn tiền nhất.
Bản đầy đủ 8 điểm kiểm tra và bối cảnh phân loại nằm ở Checklist 8 điểm cho pipeline dữ liệu chạy bằng LLM và Phân loại 6.672 than phiền bằng LLM.